N+1을 줄이려고 fetch join을 붙였는데, 목록에 페이지 제한을 걸자 메모리에서 페이징한다는 경고가 뜹니다. 검색하면 ‘컬렉션 fetch join과 페이징은 함께 쓰면 안 된다’는 설명이 많습니다. 그런데 Hibernate 7.4부터는 지원하는 데이터베이스에서 이 조합을 처리하는 방식이 달라졌습니다. 이제는 사용 중인 Hibernate 버전과 실제 SQL을 함께 봐야 합니다.
이 글은 게시글 하나에 댓글 여러 개가 달린 Article.comments 컬렉션을 기준으로 설명합니다. 같은 HQL을 Hibernate 6.6.0.Final과 7.4.12.Final에서 실행하고, 결과뿐 아니라 SQL의 페이지 제한 위치를 비교했습니다.
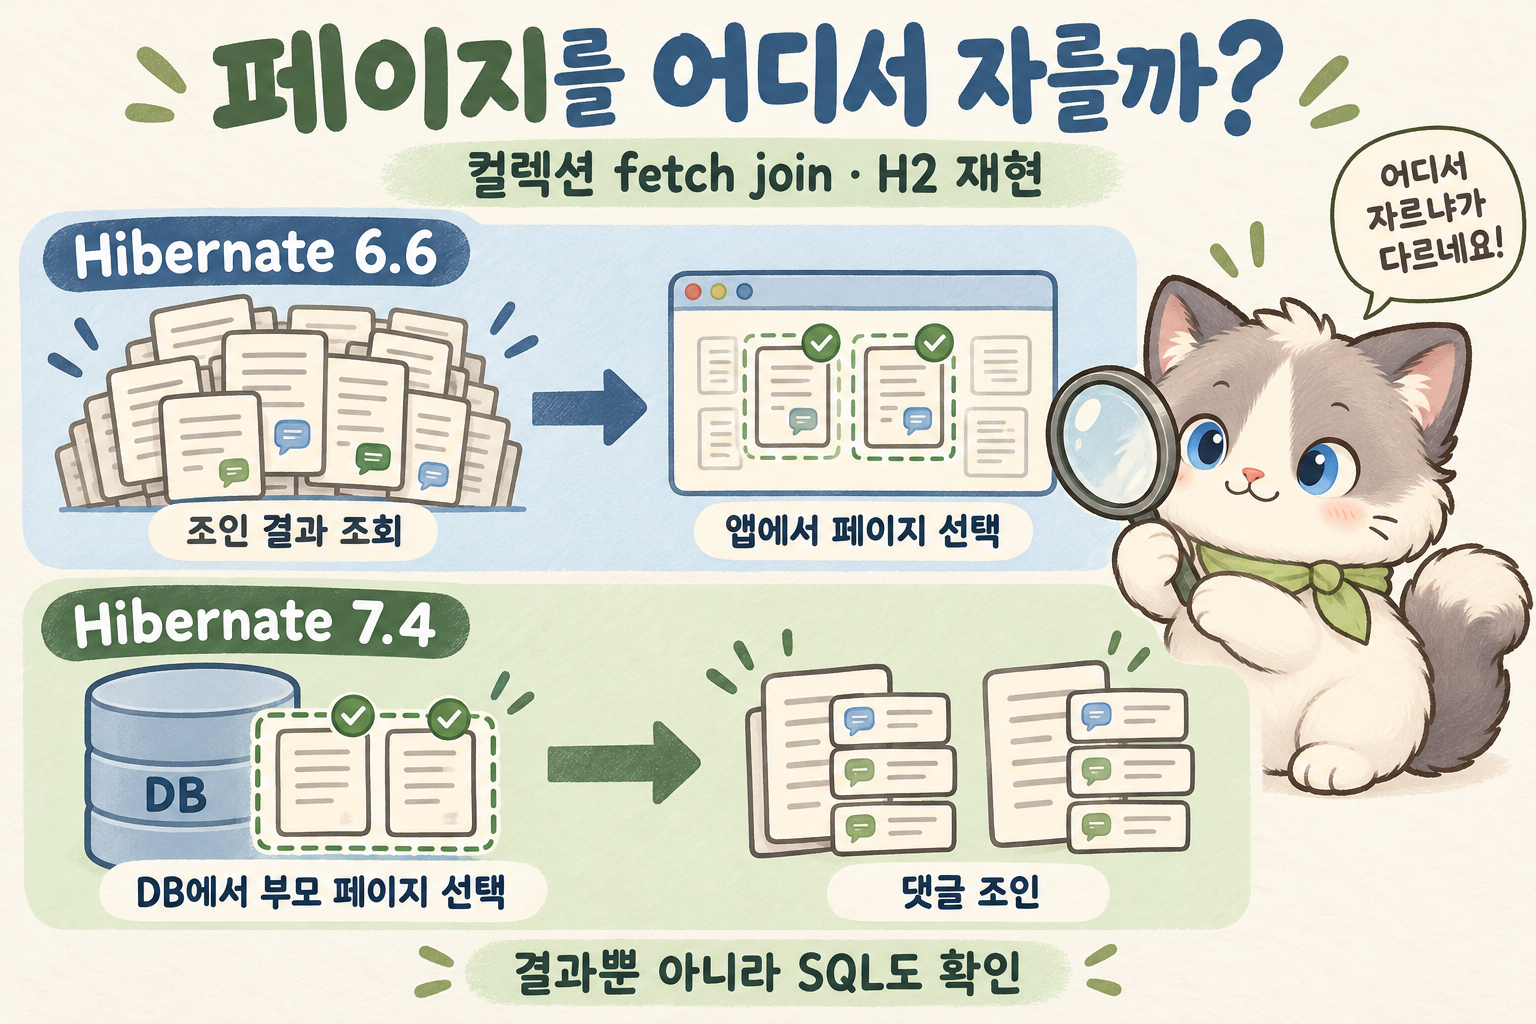
댓글 행 두 개와 게시글 두 개는 다릅니다
게시글 1번에 댓글 세 개, 2번에 한 개가 있다면 조인 결과에서 1번 게시글의 행이 여러 번 나타납니다. 이 조인 행에 단순히 두 행 제한을 걸면 게시글 두 개를 가져오는 대신 첫 게시글의 댓글 일부만 잘라 올 수 있습니다.
반면 우리가 원하는 목록은 게시글 두 개와 각 게시글에 속한 댓글 전체입니다. 이 차이가 컬렉션 fetch join의 페이징을 어렵게 만듭니다. 다대일처럼 하나의 연관 대상을 가져오는 경우까지 모두 같은 문제로 묶지는 마세요.
같은 HQL을 두 버전에서 실행했습니다
테스트 데이터는 ID가 1·2·3·4인 게시글 네 개이며 댓글 수는 각각 3·1·4·2개입니다. 정렬은 게시글 ID 오름차순, 첫 결과를 한 개 건너뛰고 두 개를 요청했습니다. 기대 결과는 게시글 [2, 3]과 댓글 수 [1, 4]입니다.
List<Article> page = session.createQuery("""
    select a from Article a
    left join fetch a.comments
    order by a.id
    """, Article.class)
    .setFirstResult(1)
    .setMaxResults(2)
    .getResultList();
두 버전 모두 기대한 게시글과 댓글을 반환했습니다. 여기까지만 보면 차이를 놓칩니다. H2 2.4.240, JDK 25.0.3에서 캡처한 SQL을 비교하면 페이지를 제한하는 위치가 달랐습니다.
| 확인 환경 | 실제로 확인한 차이 |
|---|---|
| Hibernate 6.6.0.Final | 컬렉션 조인 SQL에 offset·fetch 제한이 없었습니다. 결과를 메모리에서 제한한다는 경고가 나왔습니다. |
| Hibernate 7.4.12.Final | 부모 게시글을 고르는 서브쿼리에 offset·fetch 제한이 생겼고, 그 결과에 댓글이 조인됐습니다. |
6.6 실행에서 반환 리스트의 크기는 두 개였지만 SQL 자체는 조인 결과를 제한하지 않았습니다. page.size()만 검사해서는 이 차이를 알아낼 수 없습니다. 이번 실험은 동작과 SQL 구조를 검증한 것이며 대용량 성능이나 메모리 사용량을 측정한 벤치마크는 아닙니다.
7.4에서는 부모 페이지를 먼저 제한하는 SQL이 나왔습니다
다음은 7.4.12.Final에서 실행된 SQL을 줄바꿈만 정리한 것입니다. 안쪽 쿼리가 게시글의 페이지를 고르고, 바깥쪽 쿼리가 선택된 게시글의 댓글을 가져옵니다.
select a1_0.id, c1_0.article_id, c1_0.id
from (
    select a1_0.id
    from blog_article a1_0
    order by a1_0.id
    offset ? rows fetch first ? rows only
) a1_0(id)
left join blog_comment c1_0 on a1_0.id = c1_0.article_id
order by a1_0.id
Hibernate 7.4 변경 문서는 서브쿼리 안의 limit·offset을 지원하는 DB에서 컬렉션 fetch join과 HQL limit 또는 setMaxResults()를 함께 사용할 수 있다고 설명합니다. 해당 문서가 밝힌 지원 DB 중 예외는 Sybase ASE입니다. 이 글에서 직접 확인한 DB는 H2 하나입니다.
따라서 ‘JPA가 전부 이렇게 바뀌었다’고 이해하면 범위가 넓어집니다. Hibernate 구현의 변경이며, 실제 의존성 버전과 사용하는 DB 방언을 확인해야 합니다. Spring Boot 버전 이름만 보고 Hibernate 버전을 추정하지 말고 의존성 목록이나 시작 로그를 확인하세요.
또한 부모를 두 개만 고르더라도 그 부모에 댓글이 매우 많으면 조인 결과는 여전히 커질 수 있습니다. 여러 컬렉션을 한꺼번에 fetch join하는 문제나 복잡한 정렬의 비용까지 사라진 것은 아닙니다.
구버전에서는 조용한 메모리 페이징을 먼저 막습니다
운영 목록에서 메모리 페이징을 허용하고 싶지 않다면 다음 설정으로 조기에 실패하게 만들 수 있습니다. Spring Boot 설정 파일에 Hibernate 속성을 전달하는 형태입니다.
spring.jpa.properties.hibernate.query.fail_on_pagination_over_collection_fetch=true같은 테스트에서 이 옵션을 켜면 6.6.0.Final은 예외를 던졌습니다. 7.4.12.Final과 H2 조합은 DB에서 페이지를 제한할 수 있어 정상 결과를 반환했습니다. 경고를 숨기는 대신, 현재 쿼리가 어느 경로로 실행되는지 확인할 수 있습니다.
7.4에는 과거 동작을 선택하는 org.hibernate.limitInMemory 쿼리 힌트도 있습니다. 공식 문서는 성능에 불리할 수 있다고 경고합니다. 새 SQL이 예상과 다르다는 이유만으로 이 힌트를 기본값처럼 추가하기보다 실행 계획과 결과부터 확인하세요.
부모 ID를 먼저 고르는 두 단계 조회도 선택지입니다
기존 버전을 유지해야 하거나 페이지 조회를 명시적으로 나누고 싶다면, ID 목록을 먼저 페이징한 뒤 그 ID의 연관 데이터를 가져올 수 있습니다. 아래는 앞의 예제와 같은 결과를 두 버전 모두에서 확인한 코드입니다. 엔티티와 매핑은 그대로 두고 조회 부분을 바꿉니다.
List<Long> ids = session.createQuery("""
    select a.id from Article a order by a.id
    """, Long.class)
    .setFirstResult(1)
    .setMaxResults(2)
    .getResultList();

List<Article> articles = ids.isEmpty() ? List.of()
    : session.createQuery("""
        select a from Article a
        left join fetch a.comments
        where a.id in :ids
        order by a.id
        """, Article.class)
        .setParameter("ids", ids)
        .getResultList();
첫 쿼리는 DB에서 ID 두 개를 고릅니다. 두 번째 쿼리에는 페이지 제한을 다시 붙이지 않습니다. 빈 ID 목록은 미리 처리했고, 이 예제는 두 쿼리 모두 ID 순서로 정렬합니다. IN 절 자체가 입력 목록의 순서를 보장하는 것은 아니므로 정렬 기준이 달라지면 결과 순서도 맞춰야 합니다.
두 조회 사이에 데이터가 바뀔 수 있는 서비스라면 읽기 트랜잭션과 DB 격리 수준에 따른 일관성도 검토해야 합니다. 전체 건수를 제공하는 화면은 별도의 count 쿼리가 필요하며, 그 쿼리에 컬렉션 fetch join을 그대로 붙이지 않습니다.
목록을 고친 뒤에는 반환된 부모 ID, 각 컬렉션의 완전성, SQL의 제한 위치를 함께 확인하세요. fetch join을 붙인 목적부터 다시 살펴보고 싶다면 LAZY로 바꿔도 N+1이 남는 이유를 이어 읽을 수 있습니다.
확인 기준: 2026년 10월 9일. 각 버전에서 세 가지 테스트를 실행했습니다. H2·단일 컬렉션·ID 정렬 범위이며 실제 운영 DB의 실행 계획과 동시 수정 조건은 별도로 확인해야 합니다.
'Spring Data > JPA' 카테고리의 다른 글
| JPA N+1 문제, LAZY로 바꿨는데 왜 쿼리는 여전히 많을까? (0) | 2026.10.08 |
|---|---|
| JPA 소개 - SQL 중심적인 개발의 문제점 (0) | 2023.01.03 |


댓글